Eine neue Leistungsseite ist veröffentlicht, wird von Google aber nicht abgerufen. Im Gespräch fällt der Satz: „Vielleicht liegt es an der robots.txt.“ Für eine belastbare Antwort müssen Sie nicht sofort Dateien verändern. Wenn Sie die robots.txt in WordPress prüfen, sollten Sie zuerst klären, was verhindert werden soll: ein Abruf durch Crawler, eine Aufnahme in Suchergebnisse oder der Zugriff auf vertrauliche Inhalte.
Diese Ziele benötigen unterschiedliche Maßnahmen. Der folgende Ablauf hilft kleinen und mittleren Unternehmen, eine bestehende Konfiguration zu verstehen und Änderungen gezielt prüfen zu lassen.
Crawling ist nicht dasselbe wie Indexierung
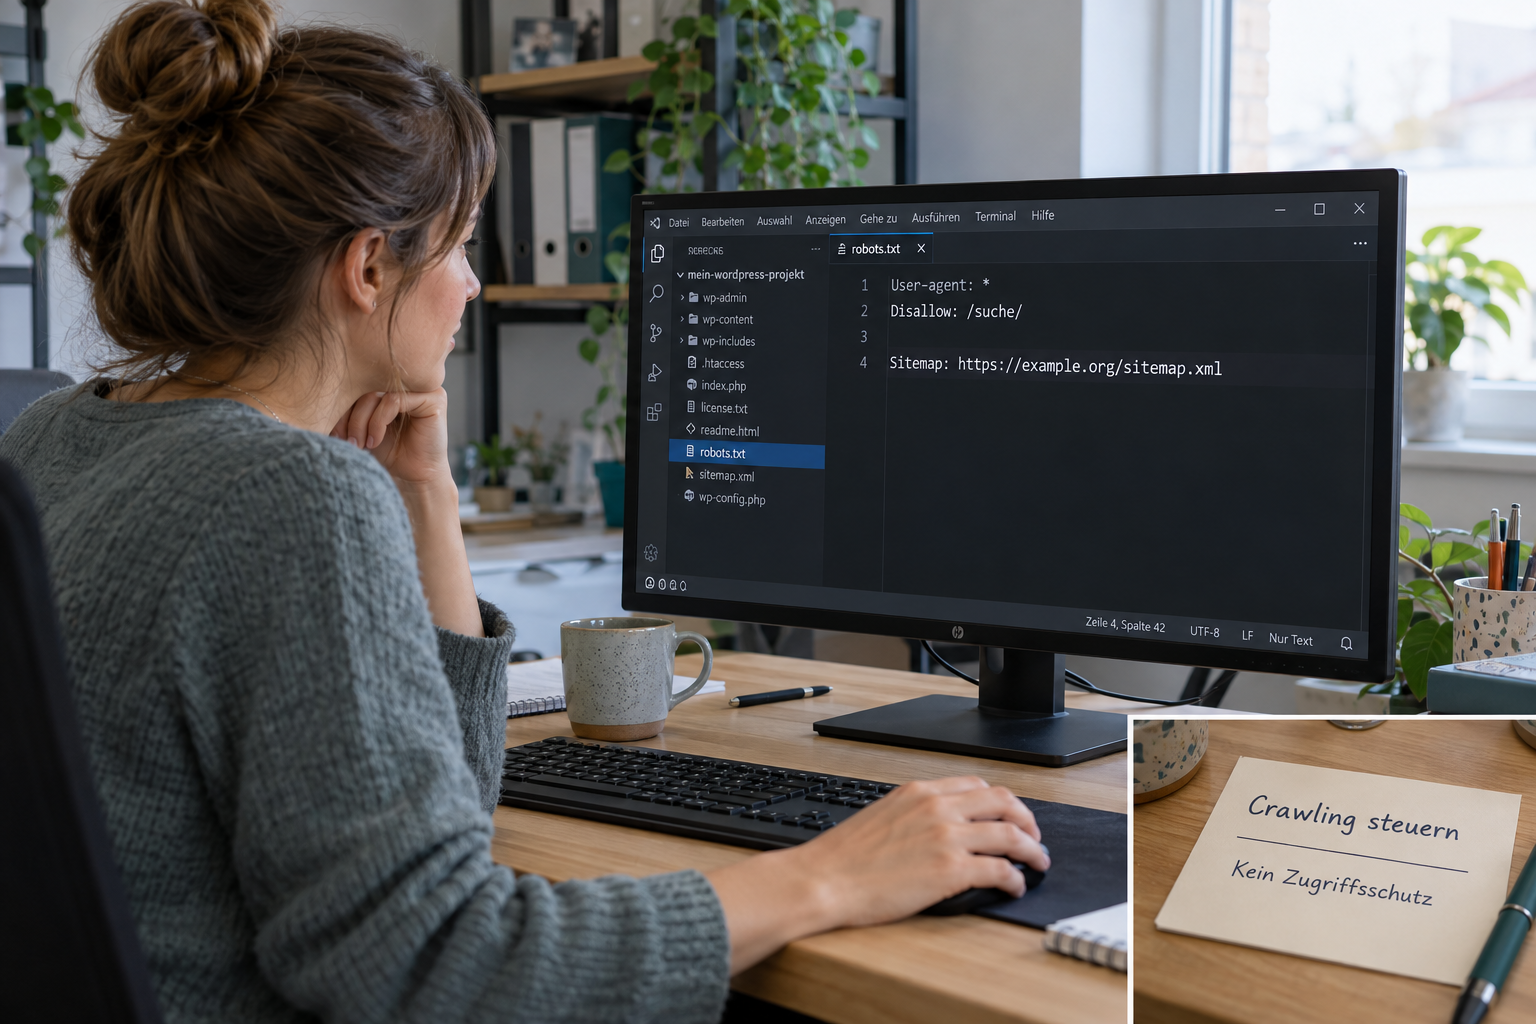
Die robots.txt teilt kooperierenden Crawlern mit, welche URLs sie abrufen dürfen. Sie ist kein zuverlässiges Mittel, um eine bekannte Webseitenadresse aus Google auszuschließen. Google erläutert in seiner Einführung zu robots.txt, dass eine blockierte URL weiterhin in Suchergebnissen auftauchen kann, beispielsweise wenn andere Seiten darauf verlinken.
Ebenso wenig ist die Datei ein Zugangsschutz. Menschen und Programme können eine öffentlich erreichbare Seite weiterhin öffnen; nicht jeder Crawler hält sich an die Regeln. Vertrauliche Inhalte benötigen einen geeigneten Zugriffsschutz. Für eine Testwebsite reicht ein eingetragener Pfad in der robots.txt deshalb nicht aus. Wie eine getrennte Umgebung vorbereitet wird, behandeln wir im Beitrag zu WordPress-Staging.
1. Das Ziel und die betroffene URL festhalten
Formulieren Sie einen konkreten Prüffall: „Google soll unsere öffentliche Leistungsseite abrufen können“ oder „Eine große Menge unwichtiger Varianten soll nicht unnötig gecrawlt werden“. Schreiben Sie die vollständige Adresse daneben. Ein pauschales „SEO funktioniert nicht“ lässt sich mit der robots.txt allein nicht untersuchen.
Grenzen Sie den Fall außerdem vom normalen Veröffentlichungsablauf ab. Eine erreichbare und erlaubte Seite ist dadurch noch nicht automatisch indexiert. Die Grundlagen dazu erklärt unser Artikel Was ist SEO?. So bleibt klar, ob Sie gerade eine technische Sperre prüfen oder ein anderes Problem suchen müssen.
2. Die öffentlich ausgelieferte Datei aufrufen
Rufen Sie die robots.txt an der Wurzel des verwendeten Hosts auf, beispielsweise https://example.com/robots.txt. Google beschreibt in der Anleitung zum Erstellen und Prüfen, dass die Regeln zum jeweiligen Protokoll, Host und Port gehören. Eine Datei auf der Hauptdomain gilt nicht automatisch auch für eine Subdomain.
Speichern Sie den angezeigten Text zusammen mit Datum und Adresse als Ausgangsstand. Notieren Sie auch, wenn statt des erwarteten Textes eine Fehlermeldung oder Anmeldeseite erscheint. Eine Dateiansicht im Hostingpanel beweist noch nicht, dass öffentlich derselbe Inhalt ausgeliefert wird.
WordPress kann eine robots.txt-Antwort selbst erzeugen; das zeigt die offizielle Funktionsdokumentation zu do_robots(). Klären Sie deshalb, welcher Mechanismus in Ihrer Installation zuständig ist, bevor Sie eine weitere Datei oder Erweiterung hinzufügen. Dieser Beitrag gibt bewusst keine ungeprüfte Klickfolge für ein bestimmtes SEO-Plugin vor.
3. Regeln mit konkreten Beispielen lesen
Eine Regelgruppe benennt mit User-agent den angesprochenen Crawler. Ein Disallow-Eintrag schließt einen passenden Pfad vom Crawling aus; Allow kann einen Zugriff innerhalb eines sonst blockierten Bereichs erlauben. Wie Google Gruppen und Pfade auswertet, steht in der robots.txt-Spezifikation. Relevant sind unter anderem die passende Crawlergruppe, der genauere Pfad und die Groß- und Kleinschreibung im Pfad.
Übertragen Sie das in eine kleine Prüfliste. Nennen Sie pro beabsichtigter Regel mindestens eine URL, die betroffen sein soll, und eine wichtige URL, die erreichbar bleiben muss. Bei Mustern oder mehreren überlappenden Gruppen sollte die technische Umsetzung anhand dieser Beispiele geprüft werden. Lesen Sie nicht nur einzelne Zeilen losgelöst vom gesamten Regelsatz.
Eine Liste aus einem fremden Blog ist keine passende Standardeinstellung für jeden WordPress-Auftritt. Ein Pfad kann in einer Installation unwichtig sein und in einer anderen notwendige Inhalte oder Funktionen enthalten. Ohne Kenntnis dieser Aufgabe ist das bloße Kopieren keine begründete Entscheidung.
Warum Disallow und noindex sich in die Quere kommen können
Wenn eine öffentlich erreichbare Seite nicht in den Google-Index aufgenommen werden soll, kommt unter passenden Voraussetzungen eine noindex-Anweisung im Meta-Tag oder HTTP-Header infrage. Google muss die Seite jedoch abrufen können, um diese Anweisung zu lesen. Blockiert die robots.txt den Abruf, kann Google ein dort vorhandenes noindex nicht erkennen.
Das erklärt die Google-Dokumentation zum Blockieren der Indexierung. Eine noindex-Zeile direkt in der robots.txt unterstützt Google nicht. „Wir tragen sicherheitshalber beides ein“ kann deshalb genau die beabsichtigte Wirkung verhindern. Bei privaten Inhalten ist wiederum Zugriffsschutz die richtige Fragestellung; dafür sollte die Seite nicht einfach öffentlich gemacht werden, nur damit ein Crawler eine Anweisung lesen kann.
Fiktives Beispiel: Nach einem Umbau fehlt eine Leistungsseite
Ein erfundener Metallbaubetrieb ergänzt einen neuen Bereich für Geländer. Nach dem Umbau meldet eine technische Prüfung eine Crawling-Sperre für die entsprechende URL. Das Team sammelt zunächst die öffentliche robots.txt und die betroffenen Adressen. Eine ältere, breit gefasste Regel schließt auch den neuen Bereich ein.
Die Aufgabe an die zuständige Person lautet nicht „Sperren entfernen“, sondern: Der neue Leistungsbereich soll erreichbar sein; die bisher bewusst ausgeschlossenen Varianten sollen ihre Behandlung behalten. Dazu benennt das Team einen Hauptartikel, eine Unterseite, eine Variantenadresse und eine notwendige Ressource als Prüffälle.
Nach der gezielten Anpassung werden diese Fälle erneut bewertet und die tatsächlich veröffentlichte Datei verglichen. Das Beispiel behauptet weder eine reale KIM-Kundenarbeit noch eine anschließende Indexierung. Es zeigt, weshalb eine kleine Änderung mit klaren Prüffällen besser nachvollziehbar ist als der Austausch des gesamten Regelsatzes.
4. Google-Abruf und aktuelle Datei auseinanderhalten
Mit geeignetem Search-Console-Zugriff können Sie den robots.txt-Bericht prüfen. Er zeigt unter anderem die zuletzt von Google abgerufene Version, den Abrufstatus und erkannte Probleme. Eine gerade veröffentlichte Änderung und der letzte Google-Abruf können unterschiedliche Stände sein. Notieren Sie diese Zeitpunkte getrennt.
Eine syntaktisch lesbare Datei beweist noch nicht, dass Ihre gewünschte URL erlaubt ist. Und eine erlaubte URL beweist keine Indexierung. Beurteilen Sie Dateiabruf, konkrete Regelwirkung und Seitenindexierung daher als getrennte Fragen. Für wichtige Seiten kann ergänzend die URL-Prüfung helfen, einen gemeldeten Abrufgrund einzuordnen.
Änderungen klein und überprüfbar halten
Vereinbaren Sie vor einer Änderung die zuständige Person, den gesicherten Ausgangsstand und die anschließenden Prüffälle. Blockieren Sie keine für das Verständnis einer Seite wichtigen Ressourcen. Halten Sie das Ergebnis und offene Fragen fest, statt aus einer verschwundenen Warnung sofort einen SEO-Erfolg abzuleiten.
Wenn Sie die technische Grundlage Ihrer Unternehmenswebsite prüfen möchten, finden Sie bei KIM Systems Unterstützung für Webseiten. Der sinnvolle Anfang ist ein konkretes Ziel mit betroffenen Adressen – keine möglichst lange robots.txt.